Trong bài này
- Ba từ ai cũng trộn lẫn
- Ba từ, ba câu hỏi
- Câu hỏi một: ghi xuống đĩa bằng cách nào?
- Đường ghi
- Đường đọc, và Bloom filter
- Đánh đổi có tên gọi: amplification
- Câu hỏi hai: tìm bằng cách nào?
- Câu hỏi ba: dòng dữ liệu nằm ở đâu?
- InnoDB và Postgres thực sự làm gì
- Vì sao điều này đổi cách bạn thiết kế
- Chỗ mình đã hiểu sai
- Ai chọn đường đi: optimizer và statistics
- Đọc một plan sai
- Khi full scan là câu trả lời đúng
- Ba câu thần chú
Ba từ ai cũng trộn lẫn
Mình đang đọc chương 3 của Designing Data-Intensive Applications (bản 1) lần thứ hai thì một anh đồng nghiệp, kiểu DBA giữ ghi chú trong file text thuần, hỏi một câu rất tự nhiên: "Index primary key của em có clustered không, và nó có phải B-Tree không?" Mình mở miệng định trả lời thì nhận ra mình không biết đó là hai câu hỏi hay một. LSM-Tree, B-Tree, clustered index: mình cất cả ba vào một ngăn kéo dán nhãn "database lưu dữ liệu thế nào", và chính cái ngăn kéo duy nhất đó là nguyên nhân của mọi nhầm lẫn.
Bài này là bài mình ước đã đọc trước cuộc trò chuyện đó. Luận điểm ngắn thôi: ba thuật ngữ này trả lời ba câu hỏi khác nhau, nên chúng không chọi nhau. Một index có thể vừa là B-Tree vừa clustered, và một storage engine có thể là LSM-Tree mà vẫn đưa cho bạn thứ hoạt động như index. Sau ba khái niệm là phần thật sự quyết định query của bạn nhanh hay chậm vào sáng thứ Hai: query optimizer và statistics mà nó tin tưởng.
Ba từ, ba câu hỏi
Vậy thì tháo ngăn kéo ra thôi. Đây là cả bài trong một bảng. Nếu chỉ giữ lại thứ này, bạn đã có phần mình hiểu sai suốt nhiều năm.
| Câu hỏi | Khái niệm | Câu trả lời một dòng | Hình ảnh |
|---|---|---|---|
| Ghi xuống đĩa bằng cách nào? | LSM-Tree so với trang ghi đè tại chỗ | Ghi nối đuôi tuần tự, sắp xếp và gộp sau | Cuốn nhật ký so với sổ kế toán |
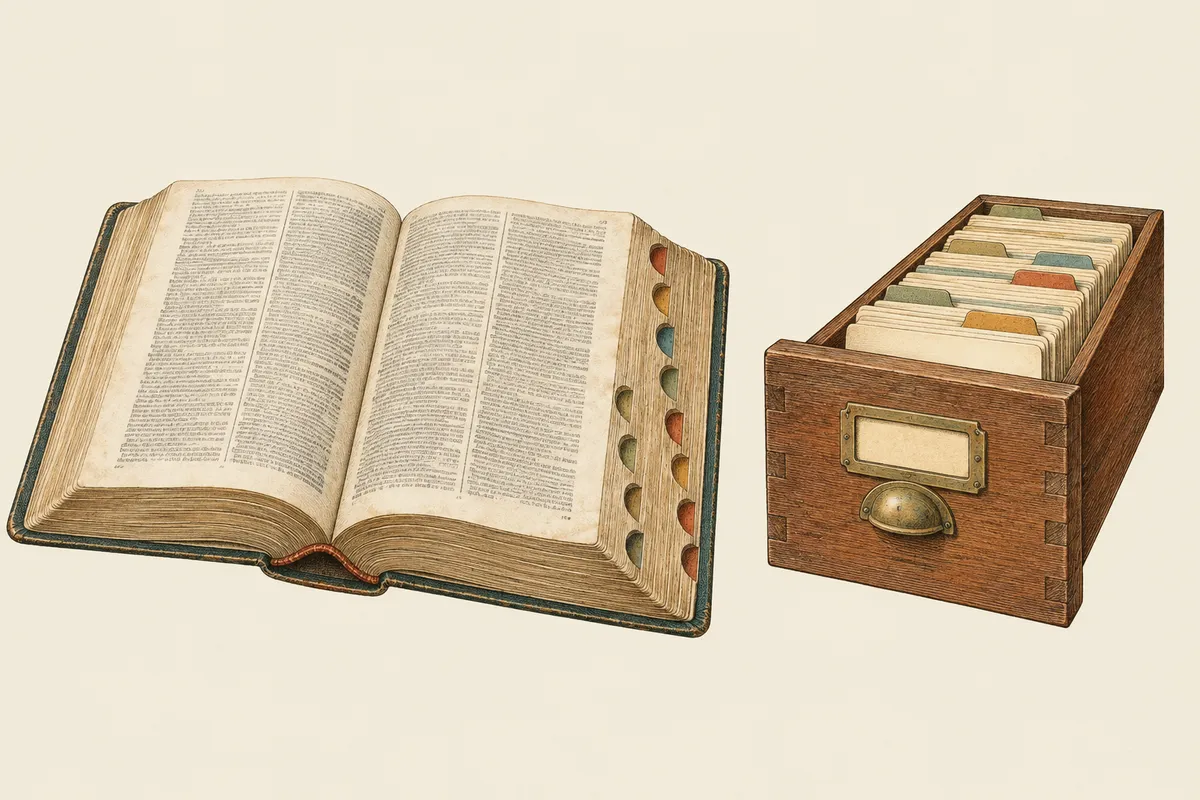
| Tìm bằng cách nào? | B-Tree | Lần xuống một cây nông gồm các trang đã sắp xếp: 3 đến 4 bước | Các nấc chữ cái ở mép từ điển |
| Dòng dữ liệu nằm ở đâu? | Clustered so với secondary | Dòng nằm ngay trong lá, hay lá chỉ giữ con trỏ | Cuốn từ điển so với bảng tra cứu cuối sách |
- câu hỏi tách biệt
- 3
- tầng B-Tree, từ vài triệu tới vài tỷ dòng
- 3-4
- clustered index mỗi bảng
- 1
- lần xuống cây khi tra secondary index trong InnoDB
- 2
Câu hỏi một: ghi xuống đĩa bằng cách nào?
Bắt đầu từ hàng đầu tiên của bảng. Hình dung hai cách giữ sổ tiền của một cửa hàng. Cuốn nhật ký: mỗi lần bán là một dòng mới ở cuối trang, không bao giờ tẩy, không bao giờ quay lại sửa. Và sổ kế toán: mỗi tài khoản có ô riêng, khi con số đổi thì tìm đúng ô đó và ghi đè. Nhật ký ghi cực nhanh vì ngòi bút không phải di chuyển. Sổ kế toán thì đọc nhanh vì mỗi câu trả lời nằm ở một chỗ đã biết. Storage engine đứng đúng trước lựa chọn này.
Sổ kế toán là họ ghi đè tại chỗ: B-Tree, trong Postgres, MySQL, Oracle, SQL Server. Nhật ký là họ log-structured: LSM-Tree (log-structured merge-tree), nằm sau RocksDB, LevelDB, Cassandra, HBase. Kleppmann dành nửa đầu chương 3 cho phía nhật ký, bắt đầu từ một file chỉ ghi nối đuôi rồi sửa dần từng nhược điểm cho tới khi thành LSM-Tree.
Đường ghi
- WAL. Thao tác ghi được nối vào write-ahead log trên đĩa trước, chỉ để lỡ crash cũng không mất. Tuần tự, rẻ.
- Memtable. Thao tác ghi cũng đi vào một cấu trúc đã sắp xếp trong RAM (cây cân bằng hoặc skip list). Tốc độ của bộ nhớ.
- SSTable. Khi memtable vượt ngưỡng kích thước (RocksDB mặc định 64 MB), nó được flush thành một file bất biến đã sắp xếp, gọi là Sorted String Table. Không file nào bị sửa nữa.
- Compaction. Một tiến trình nền merge-sort các SSTable thành file lớn hơn, bỏ các giá trị cũ bị ghi đè trong lúc gộp, và khi đã an toàn thì bỏ luôn các key đã xóa (tombstone).
Để ý thứ còn thiếu: không có gì bao giờ được ghi vào giữa một file có sẵn. Mọi thao tác ghi xuống đĩa đều tuần tự, thứ mà ổ đĩa và SSD ưa nhất. Toàn bộ mẹo nằm ở đó.
Đường đọc, và Bloom filter
Cái giá nằm ở phía đọc. Một key có thể nằm trong memtable, hoặc trong bất kỳ SSTable nào, và bản mới nhất thắng, nên tra kiểu ngây thơ có thể phải kiểm tra tất cả. Cách chữa là một Bloom filter cho mỗi SSTable: mảng bit gọn trả lời "key K có trong file này không?" bằng "chắc chắn không" hoặc "có thể". Nó không bao giờ sai kiểu false negative; nó chỉ cho false positive ở tỷ lệ bạn chọn (khoảng 1% với 10 bit mỗi key, mức mà tài liệu RocksDB nêu như một cấu hình phổ biến). Một phép kiểm tra rẻ trong RAM giúp engine bỏ qua gần hết các file không chứa key.
Đánh đổi có tên gọi: amplification
Kỹ sư đo sự đánh đổi này bằng hai tỷ lệ. Write amplification là số byte thực sự ghi xuống đĩa trên mỗi byte ứng dụng ghi. Read amplification là số chỗ phải kiểm tra cho một lần tra. B-Tree ghi lại cả một trang (4 đến 16 KB) chỉ để đổi vài byte, cộng thêm bản ghi WAL, nên nó cũng có write amplification. LSM-Tree ghi lại mỗi mẩu dữ liệu thêm một lần mỗi khi compaction gộp nó vào tầng lớn hơn, và con số phụ thuộc nhiều vào chiến lược compaction cùng tỷ lệ kích thước giữa các tầng. Phía đọc thì ngược lại: LSM kiểm tra nhiều file, B-Tree chỉ đi một đường. Mình sẽ không chốt một con số duy nhất, vì câu trả lời thật thà là "tùy cấu hình và tùy dữ liệu của bạn". DDIA cũng nói vậy: LSM-Tree thường chịu được throughput ghi cao hơn, nhưng compaction có thể ăn băng thông và gây đỉnh latency ở phần đuôi (vì sao những đỉnh đó đau đến vậy là chuyện của bài về tail latency).
Câu hỏi hai: tìm bằng cách nào?
Ghi xuống đĩa mới là một nửa chuyện: byte nằm trên đĩa mà không tìm lại được thì vô dụng. Lấy một cuốn từ điển dày. Bạn không đọc từ trang đầu. Bạn nhìn các nấc chữ cái ở mép sách, nhảy tới chữ P, lướt góc trên của từng trang để tìm pe-, rồi pen, rồi tới từ cần tìm. Ba bốn bước thu hẹp là xong. B-Tree chính là thế: một cây các trang kích thước cố định, đã sắp xếp, mỗi trang chứa nhiều key và con trỏ giữa chúng, nên một trang thu hẹp khoảng tìm đi hàng trăm lần.
Phép tính này đáng làm một lần. Giả sử một trang chứa khoảng 500 con trỏ con (con số DDIA dùng; với key ngắn thì hợp lý ngay cả với trang 4 KB). Gốc trỏ tới 500 con, hai tầng với tới 250.000 trang, ba tầng 125 triệu, bốn tầng 62,5 tỷ. DDIA tính cùng ví dụ với trang 4 KB: 62,5 tỷ trang nhân 4 KB là 256 TB, và đó là mức tối đa của một cây bốn tầng. Nên một bảng một trăm triệu dòng chỉ cách mọi dòng 3 đến 4 lần đọc trang, và một hai tầng trên cùng gần như luôn nằm sẵn trong cache, nên thực tế một lần tra thường tốn một hai lần đọc đĩa thật. Đó là "O(log n)" bạn hay nghe, với cơ số lớn đến mức cảm giác như hằng số.
Hai chú thích thật thà. Một, "mọi index trong Postgres và MySQL đều là B-Tree" là mặc định tốt chứ không phải định luật: Postgres còn có index hash, GIN, GiST và BRIN cho những dạng dữ liệu đặc biệt, dù CREATE INDEX cho bạn B-Tree nếu bạn không nói gì thêm. Hai, B-Tree giữ key đã sắp xếp, và đó là lý do nó trả lời được cả truy vấn khoảng (BETWEEN, ORDER BY) dễ như so sánh bằng: tìm điểm đầu, rồi đi dọc các lá.
Để ý rằng câu hỏi này độc lập với câu hỏi một. LSM-Tree trả lời nó theo cách khác (một lần tra hỏi memtable và các SSTable qua file đã sắp xếp và Bloom filter), nhưng vẫn cần một cách nào đó để tìm. Chính vì thế "LSM so với B-Tree" là cách đặt vấn đề hơi thiếu công bằng: chúng khác nhau nhiều nhất ở cột ghi, và chỉ gián tiếp ở cột tìm kiếm.
Câu hỏi ba: dòng dữ liệu nằm ở đâu?
Quay lại cuốn từ điển. Khi bạn tới chữ apple, nghĩa của nó nằm ngay trên cùng dòng. Bạn không phải lật đi đâu khác. Từ điển là chính dữ liệu, sắp xếp theo một quy tắc duy nhất, và vì nó được xếp thật theo quy tắc đó nên chỉ có thể có một cách xếp như vậy. Đó là cấu trúc clustered.
Giờ lấy một cuốn giáo trình thường có bảng tra cứu ở cuối sách: "replication, 151, 153, 160". Tìm mục thì nhanh (bảng xếp theo bảng chữ cái, một B-Tree nhỏ riêng), nhưng nó chỉ đưa bạn một số trang. Rồi bạn lật tới trang 151. Đó là index non-clustered (secondary): lá giữ một con trỏ, và thêm một bước nhảy mới lấy được thứ thật. Một cuốn sách có thể có nhiều bảng tra cứu (tên, chủ đề, địa danh); nhưng không thể in vật lý theo nhiều thứ tự cùng lúc.
InnoDB và Postgres thực sự làm gì
Đây là chỗ sách vở (và cả ghi chú đầu tiên của mình) hay qua loa, nên nói cho chính xác.
- MySQL InnoDB: mỗi bảng chính là một B-Tree khóa theo primary key, và các lá chứa nguyên dòng. Bảng luôn clustered theo primary key (nếu không khai báo PK, InnoDB lấy index unique NOT NULL đầu tiên, hoặc một row id ẩn). Mỗi secondary index lưu trong lá cột được index cùng giá trị primary key của dòng (không phải địa chỉ vật lý). Vì vậy tra qua secondary index là hai lần đi xuống B-Tree: một trong secondary index để lấy PK, một trong cây clustered để lấy dòng.
- PostgreSQL: bảng là một heap, đống trang không theo thứ tự, dòng mới rơi vào chỗ nào còn trống. Mọi index đều là secondary, kể cả index của primary key. Lá của nó trỏ tới vị trí vật lý, tuple id (số trang cộng slot). Một lần xuống cây, rồi một lần lấy từ heap. Lệnh
CLUSTERcó tồn tại, nhưng chỉ là sắp xếp lại vật lý một lần heap theo một index: dòng mới sau đó không được giữ đúng thứ tự, và lệnh này giữ lock nặng khi chạy. Nên "Postgres là clustered" là sai; "Postgres sắp xếp lại được một lần" mới đúng. - SQL Server, Oracle: SQL Server cho chọn một clustered index mỗi bảng hoặc để bảng là heap; ở Oracle bảng heap là mặc định, còn index-organized table là biến thể clustered. Cùng ý tưởng, mặc định khác nhau.
-- MySQL / InnoDB: index của PK CHÍNH LÀ bảng
CREATE TABLE users (
  id    BIGINT PRIMARY KEY,         -- clustered: lá chứa nguyên dòng
  email VARCHAR(255) NOT NULL,
  name  VARCHAR(100),
  KEY idx_email (email)             -- secondary: lá = (email, id)
) ENGINE = InnoDB;

SELECT * FROM users WHERE id = 42;                -- một lần xuống cây
SELECT * FROM users WHERE email = 'a@example.com'; -- hai lần (email -> id -> dòng)
SELECT id FROM users WHERE email = 'a@example.com'; -- một lần: PK đã nằm sẵn trong lá

-- PostgreSQL: heap không được sắp xếp theo thứ gì
CREATE INDEX users_email_idx ON users (email);
CLUSTER users USING users_email_idx;  -- sắp xếp lại heap MỘT LẦN, giữ ACCESS EXCLUSIVE lock
Vì sao điều này đổi cách bạn thiết kế
- Giữ primary key của InnoDB ngắn. Nó được chép vào lá của mọi secondary index, nên PK là chuỗi UUID 36 ký tự làm mọi secondary index béo hơn hẳn so với số nguyên 8 byte.
- PK ngẫu nhiên làm insert bị rải khắp nơi. Bảng clustered giữ dòng theo thứ tự key, nên UUID ngẫu nhiên rơi mỗi dòng mới vào một lá ngẫu nhiên, gây tách trang khắp cây, còn id tăng dần luôn nối vào mép phải. Đó là lý do id có thứ tự thời gian (UUIDv7, kiểu snowflake) được ưa chuộng.
- Covering index bỏ được bước nhảy. Nếu secondary index đã chứa mọi cột query cần, engine không bao giờ ghé dòng: "Using index" ở InnoDB, "Index Only Scan" ở Postgres (còn phụ thuộc visibility map được cập nhật).
Chỗ mình đã hiểu sai
Giờ mình có thể thú nhận chỗ mọi thứ đã sụp đổ với mình, và đó là phần xấu hổ. Lần đầu tự giải thích cho mình, mình nói: "clustered là ghi tuần tự." Nghe có lý, vì "cluster" gợi cảm giác "gom nhóm" và ghi tuần tự là thứ mình vừa đọc ở phần LSM. Nhưng mình đã lấy đặc tính ghi của LSM-Tree gắn cho một khái niệm nói về vị trí. Clustered không nói gì về cách byte đi xuống đĩa; nó nói dòng nằm ở đâu so với index.
Lỗi thứ hai tinh vi hơn. Được hỏi nên chọn engine nào cho một service ghi log 50.000 sự kiện mỗi giây, mình trả lời "LSM", đúng, rồi biện minh bằng "vì đọc sẽ nhanh". Sai lý do. Gánh nặng của tải đó là tốc độ ghi, và thứ LSM mang lại là ghi tuần tự rẻ. Đọc mới là phần bạn phải trả thêm. Đáp án đúng, câu hỏi sai, và đó là tổ hợp nguy hiểm, vì tải kế tiếp sẽ không dễ tha như vậy.
| Tải | Nghiêng về | Vì |
|---|---|---|
| Ghi như mưa: log, metric, IoT, event stream | LSM-Tree (RocksDB, Cassandra) | Ghi tuần tự; compaction trả hóa đơn sau |
| Đọc ổn định, transaction, tra điểm và tra khoảng | B-Tree (Postgres, MySQL) | Một đường đi dự đoán được cho mỗi lần đọc, locking và MVCC đã chín |
Ai chọn đường đi: optimizer và statistics
Vài tuần sau, cũng anh DBA đó chỉ cho mình một query chậm và nói đúng một câu: "Trước khi đụng vào SQL, cập nhật statistics đã." Ghi chú của anh về chuyện này, mình giữ lại, rất ngắn: optimizer chọn plan bằng cách ước lượng chi phí, và ước lượng đó đến từ statistics. Đầu vào rác thì đầu ra rác.
Hình ảnh khiến mình nhớ lâu là Google Maps. Optimizer là ứng dụng; statistics là dữ liệu giao thông trực tiếp. Nếu nguồn giao thông đóng băng từ 3 giờ sáng, ứng dụng sẽ hồn nhiên dẫn bạn vào một cao tốc giờ đã thành bãi đỗ xe. Ứng dụng không ngu; dữ liệu của nó đã cũ. Planner của database có cùng điểm yếu: nó không nhìn bảng, nó nhìn một bản tóm tắt nhỏ về bảng (số dòng, số giá trị phân biệt, histogram, các giá trị phổ biến nhất), rồi chọn giữa full scan, index scan hay bitmap scan dựa trên bản tóm tắt đó.
Đọc một plan sai
Trong Postgres, dấu hiệu nằm ở EXPLAIN ANALYZE: so số dòng ước lượng với số dòng thực tế. Kết quả dưới đây chỉ để minh họa (định dạng là thật, con số là bịa ra để thấy mẫu hình). Hình dung bảng orders khoảng 2,9 triệu dòng, lần analyze gần nhất là lúc gần như mọi đơn còn ở trạng thái 'new'. Từ đó một job chạy đêm đã chuyển một nửa số đơn sang 'shipped', và không ai chạy lại ANALYZE:
EXPLAIN (ANALYZE)
SELECT * FROM orders WHERE status = 'shipped';

 Index Scan using orders_status_idx on orders
     (cost=0.43..5871.20 rows=1450 width=48)
     (actual time=0.031..1840.602 rows=1450000 loops=1)
   Index Cond: (status = 'shipped'::text)
 Planning Time: 0.210 ms
 Execution Time: 1862.412 ms
-- ước lượng rows=1450, thực tế rows=1450000: planner tin 'shipped' hiếm gấp 1000 lần so với thực tế

ANALYZE orders;   -- MySQL: ANALYZE TABLE orders;

EXPLAIN (ANALYZE)
SELECT * FROM orders WHERE status = 'shipped';

 Seq Scan on orders
     (cost=0.00..61236.00 rows=1447200 width=48)
     (actual time=0.020..310.204 rows=1450000 loops=1)
   Filter: (status = 'shipped'::text)
   Rows Removed by Filter: 1450000
 Planning Time: 0.140 ms
 Execution Time: 331.812 ms
-- ước lượng giờ khớp thực tế, và plan tự đổi theo
Chuyện của anh đồng nghiệp thì chạy theo hướng ngược lại: có người xóa khoảng 90% một bảng lớn, nhưng statistics vẫn mô tả ba triệu dòng, nên plan được tinh chỉnh cho một bảng to gấp mười lần bảng thật. Mỗi engine phản ứng với một đợt xóa hàng loạt khác nhau (Postgres chẳng hạn điều chỉnh lại ước lượng số dòng theo kích thước hiện tại của bảng, nên độ lệch hiện ra khác đi), nhưng bài học giống nhau. Postgres thường tự làm mới statistics qua autovacuum, mặc định analyze lại bảng khi khoảng 10% số dòng đã thay đổi (autovacuum_analyze_scale_factor = 0.1), và chỉ ở lượt quét kế tiếp của nó. Sau một đợt nạp lớn, một đợt dọn lớn hay thay đổi schema, đừng ngồi chờ; hãy tự chạy ANALYZE. Quy tắc nhớ nhanh: khi plan sai, sửa đầu vào (statistics) trước khi sửa đầu ra (câu SQL, hoặc hint ép buộc).
Khi full scan là câu trả lời đúng
Đây là câu hỏi làm mình băn khoăn nhất: "Mình cập nhật statistics rồi mà nó vẫn full scan. Chẳng lẽ cứ chịu?" Nghe như nhận thua. Không phải vậy. Đôi khi optimizer, giờ đã có số đúng trong tay, đúng còn trực giác của bạn sai.
Tính một lần cho rõ. Bảng 1.000.000 dòng, khoảng 100 dòng mỗi trang 8 KB, là 10.000 trang, cỡ 80 MB. Full scan đọc mỗi trang đúng một lần, theo thứ tự, thứ mà ổ đĩa và read-ahead rất thích. Giờ giả sử query cần 10% số dòng: 100.000 dòng. Qua secondary index, các dòng đó nằm rải khắp heap, nên trong trường hợp xấu nhất là tới 100.000 lần lấy trang, nhiều gấp mười lần số trang của cả bảng, nhiều lần là đọc ngẫu nhiên và một số là đọc lại chính trang cũ. Dù cả bảng nằm gọn trong cache, 100.000 lần chọn ngẫu nhiên giữa 10.000 trang vẫn chạm gần như mọi trang. Index không tiết kiệm công việc; nó nhân công việc lên.
| Yếu tố | Đẩy về phía full scan | Đẩy về phía index |
|---|---|---|
| Tỷ lệ dòng trả về | Lớn (hàng chục phần trăm) | Rất nhỏ (một phần nhỏ của một phần trăm) |
| Số dòng mỗi trang | Nhiều dòng nhỏ: mỗi trang quét được nhiều | Ít dòng rộng |
| Độ tương quan giữa index và thứ tự vật lý | Thấp: dòng khớp rải khắp nơi | Cao: dòng khớp nằm cạnh nhau (như clustered index) |
| Thiết bị lưu trữ | Đĩa quay: đọc ngẫu nhiên rất đắt | SSD, hoặc dữ liệu chủ yếu nằm trong cache |
Người ta hay nói "khoảng 10% bảng" là ranh giới mà full scan bắt đầu thắng. Hãy coi đó là quy tắc ước chừng, không phải định luật. Đây là lý do con số đó dịch chuyển. Với cấu hình cost mặc định của Postgres (seq_page_cost 1, random_page_cost 4, cpu_tuple_cost 0,01, cpu_operator_cost 0,0025), full scan bảng 1.000.000 dòng của ta tốn khoảng 10.000 + 10.000 + 2.500 = 22.500 đơn vị. Một index scan thường mà các dòng khớp nằm rải rác phải trả tới 4 đơn vị mỗi dòng chỉ riêng việc lấy trang heap, nên nó chạm 22.500 ở khoảng 5.600 dòng, tức chừng 0,6% bảng. Công thức thật mượt hơn (số lần lấy trang không thể vượt quá số trang, và index cũng có chi phí riêng), nên hãy coi đây là con số ước chừng: với index scan thường không tương quan, điểm hòa vốn nằm quanh 1%, thấp hơn 10% rất nhiều. Bitmap scan, vốn gom các dòng khớp rồi đọc trang theo thứ tự vật lý, thắng ở khoảng giữa; cấu hình hợp SSD (random_page_cost thấp hơn) đẩy mọi ngưỡng lên cao. Con số phụ thuộc dữ liệu của bạn, nên hãy đo. Bạn có thể bắt planner cho xem lựa chọn thứ hai của nó:
-- lựa chọn của planner (số minh họa, bảng 1 triệu dòng, ~38% khớp)
EXPLAIN ANALYZE SELECT count(*), sum(total) FROM orders WHERE status = 'shipped';
 Aggregate  (cost=24400.00..24400.01 rows=1 width=40) (actual time=96.290..96.291 rows=1 loops=1)
   ->  Seq Scan on orders  (cost=0.00..22500.00 rows=380000 width=8) (actual time=0.021..71.302 rows=380000 loops=1)
         Filter: (status = 'shipped'::text)
         Rows Removed by Filter: 620000
 Execution Time: 96.412 ms

-- con đường bị bỏ qua, chỉ trong session này (để chẩn đoán, không bao giờ để trong config production)
SET enable_seqscan = off;
EXPLAIN ANALYZE SELECT count(*), sum(total) FROM orders WHERE status = 'shipped';
 Aggregate  (cost=32400.00..32400.01 rows=1 width=40) (actual time=247.810..247.811 rows=1 loops=1)
   ->  Bitmap Heap Scan on orders  (cost=7500.00..30500.00 rows=380000 width=8) (actual time=41.002..231.510 rows=380000 loops=1)
         Recheck Cond: (status = 'shipped'::text)
         Heap Blocks: exact=10000
         ->  Bitmap Index Scan on orders_status_idx  (cost=0.00..7405.00 rows=380000 width=0) (actual time=39.800..39.800 rows=380000 loops=1)
               Index Cond: (status = 'shipped'::text)
 Execution Time: 247.931 ms
RESET enable_seqscan;Ba câu thần chú
Sau chuyện full scan, tờ giấy nhớ đã đủ ngắn để đọc thành tiếng. Dòng đầu là của riêng mình; mấy dòng sau là những thói quen mình giữ lại từ ghi chú của anh DBA.
Ghi như mưa thì LSM. Đọc ổn định và giao dịch thì B-Tree.
Ghi chú cho chính mình về câu hỏi một
- Clustered là cuốn từ điển (chỉ có một). Non-clustered là bảng tra cứu cuối sách (có thể nhiều). Câu hỏi ba, và nó chẳng liên quan gì tới cách ghi.
- Output sai thì kiểm tra input. Plan sai là vấn đề statistics cũ cho tới khi chứng minh được ngược lại; chạy ANALYZE trước.
- Full scan không phải thất bại. Khi query chạm một phần lớn của bảng, đọc tuần tự là plan trung thực.
Quay lại câu hỏi tưởng chừng bâng quơ của anh đồng nghiệp. Câu trả lời thật thà là "có cho cả hai, và đó là hai sự thật khác nhau." Trong InnoDB, index của primary key là B-Tree (tìm bằng cách nào) và clustered (dòng nằm ở đâu); còn cách InnoDB đưa trang xuống đĩa lại là chuyện thứ ba. Ba câu hỏi, ba câu trả lời, một ngăn kéo cuối cùng cũng được tách ra làm ba. Nếu chỉ nhớ một thói quen từ bài này, hãy nhớ hình ba cột. Hỏi một từ đang trả lời câu nào trước khi hỏi cái nào tốt hơn. Bài kế tiếp: chuyện gì xảy ra khi cái máy giữ hết chỗ dữ liệu này chết, trong bài về failover và split brain.